语音识别技术综述 从原理到前沿应用
语音识别技术旨在让机器“听懂”人类的语音,并将其转化为可处理的文本或指令。作为人机交互的核心技术之一,语音识别历经数十年发展,已从实验室走向大规模商用,深刻改变了我们的生活与工作方式。本文将从技术原理、发展历程、关键方法、应用场景及未来趋势等方面,对语音识别进行系统性综述。
一、语音识别的基本原理
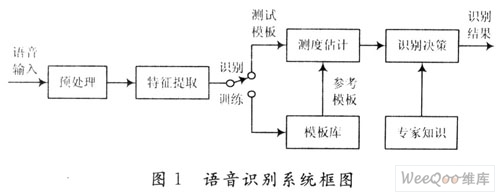
语音识别本质上是一个模式识别与序列映射问题:输入是一段语音波形,输出是对应的文字序列。其核心流程通常包括以下几个模块:
- 信号预处理与特征提取:对原始语音进行降噪、分帧、加窗等处理,然后提取能够表征语音内容的声学特征。常用的特征包括梅尔频率倒谱系数(MFCC)、滤波器组(Filter Bank)特征等。
- 声学模型:负责计算语音特征与音素(或子词单元)之间的概率关系。传统方法使用高斯混合模型-隐马尔可夫模型(GMM-HMM),现代方法则普遍采用深度神经网络(DNN)、循环神经网络(RNN)、卷积神经网络(CNN)以及Transformer等架构。
- 语言模型:用于评估一个词序列是否符合语言习惯,从而对声学模型的候选结果进行修正和排序。早期使用N-gram统计语言模型,如今神经网络语言模型(如RNN LM、Transformer LM)已成为主流。
- 解码器:结合声学模型和语言模型,在搜索空间中寻找最可能的词序列。常用的解码算法包括维特比解码、束搜索(Beam Search)以及基于加权有限状态转换器(WFST)的动态解码。
二、发展历程:从规则到深度学习
语音识别的发展大致经历了以下几个阶段:
- 早期探索(1950s-1970s):以孤立词识别为主,采用模板匹配和动态时间规整(DTW)技术,代表系统如Audrey(贝尔实验室,1952年)。
- 统计模型时代(1980s-2000s):GMM-HMM框架成为主导,引入声学-语言模型联合解码,实现了连续语音识别和大词汇量识别。期间涌现出隐马尔可夫模型、N-gram语言模型、决策树聚类等关键技术。
- 深度学习革命(2010s):DNN替代GMM,显著降低了词错误率。RNN、LSTM、CNN以及端到端(End-to-End)模型(如CTC、Seq2Seq、Transformer)相继登场,将声学、语言、发音模型融合在一个网络中,极大简化了系统 pipeline,并在多项基准测试中超越传统混合系统。
- 大模型与自监督学习(2020s至今):以wav2vec 2.0、HuBERT、WavLM为代表的自监督预训练模型,利用海量无标注语音数据学习通用语音表示,仅需少量标注数据即可微调至优异性能。Whisper等大规模弱监督模型在多语言、多任务场景下展现出强大的泛化能力。
三、关键方法与技术
现代语音识别系统涉及多个关键技术分支:
- 端到端建模:直接学习从语音到文本的映射,省去传统对齐和发音词典。典型方法包括Connectionist Temporal Classification (CTC)、基于注意力机制的Encoder-Decoder、以及RNN-Transducer (RNN-T)。
- 注意力机制与Transformer:Transformer的自注意力能够有效捕获长距离上下文依赖,已成为语音识别声学建模的主流架构,并在流式与非流式场景中均有广泛应用。
- 数据增强与正则化:如速度扰动、频谱掩蔽(SpecAugment)、混响增强等,可提升模型鲁棒性,缓解数据稀缺问题。
- 多任务学习与联合建模:将语音识别与语音合成、说话人识别、语音翻译等任务联合训练,共享底层表示,提升整体性能。
- 语言模型融合:在端到端系统中,通过浅层融合(Shallow Fusion)或深度融合(Deep Fusion)引入外部语言模型,以改善识别结果。
四、典型应用场景
语音识别技术已渗透至各行各业:
- 智能助手与智能家居:如Siri、Alexa、小爱同学等,通过语音唤醒、命令识别实现人机交互。
- 语音输入与听写:广泛应用于手机输入法、办公文档口述、医疗病历录入等,极大提升输入效率。
- 实时字幕与会议转录:为视频直播、线上会议提供自动字幕,助力无障碍沟通与信息纪要。
- 客服与呼叫中心:结合自然语言处理,实现智能客服、语音导航、情绪分析等,降低人工成本。
- 车载语音与工业控制:在驾驶、嘈杂工业环境中实现免提操作,提高安全性与效率。
- 医疗与辅助技术:帮助听障人士进行语音转文字,或辅助医生进行语音指令操作。
五、挑战与未来趋势
尽管语音识别已取得巨大成功,仍面临诸多挑战:
- 噪声与远场:真实环境中的背景噪声、混响、多人交谈等会显著降低识别率。
- 口音与方言:不同地域、社会阶层的发音差异巨大,模型需具备更强的泛化能力。
- 多语言与代码转换:在同一个句子中混合多种语言(如中英夹杂)是常见现象,对模型提出更高要求。
- 低资源语言:缺乏标注数据的语言难以训练高性能系统,自监督学习和跨语言迁移成为解决途径。
- 隐私与安全:语音数据涉及用户隐私,如何在本地设备上高效运行、避免数据泄露是重要课题。
未来趋势包括:
- 更强大的自监督与半监督学习:利用无标注数据预训练,降低对标注数据的依赖。
- 多模态融合:结合视觉(唇读)、文本、传感器等信息,提升噪声环境下的识别鲁棒性。
- 个性化与自适应:根据用户口音、词汇习惯在线微调模型,提供定制化体验。
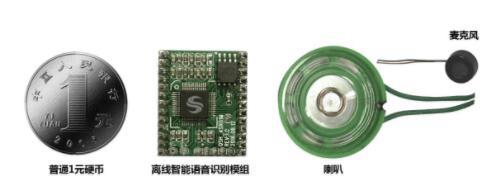
- 边缘计算与轻量化:将模型压缩、量化后部署到手机、可穿戴设备等边缘端,实现低延迟、低功耗的实时识别。
- 可解释性与公平性:提升模型决策透明度,减少对不同人群的偏见,确保技术普惠。
##
语音识别技术正处于从“能听清”向“听懂”演进的关键时期。随着深度学习、自监督学习和大规模预训练模型的持续突破,语音识别将在更多场景中实现自然人机交互,成为连接人类与数字世界的重要桥梁。我们也需关注其带来的隐私、伦理和社会影响,推动技术向更加智能、包容和可靠的方向发展。
如若转载,请注明出处:http://www.dashuzn.com/product/56.html
更新时间:2026-10-30 09:47:08